
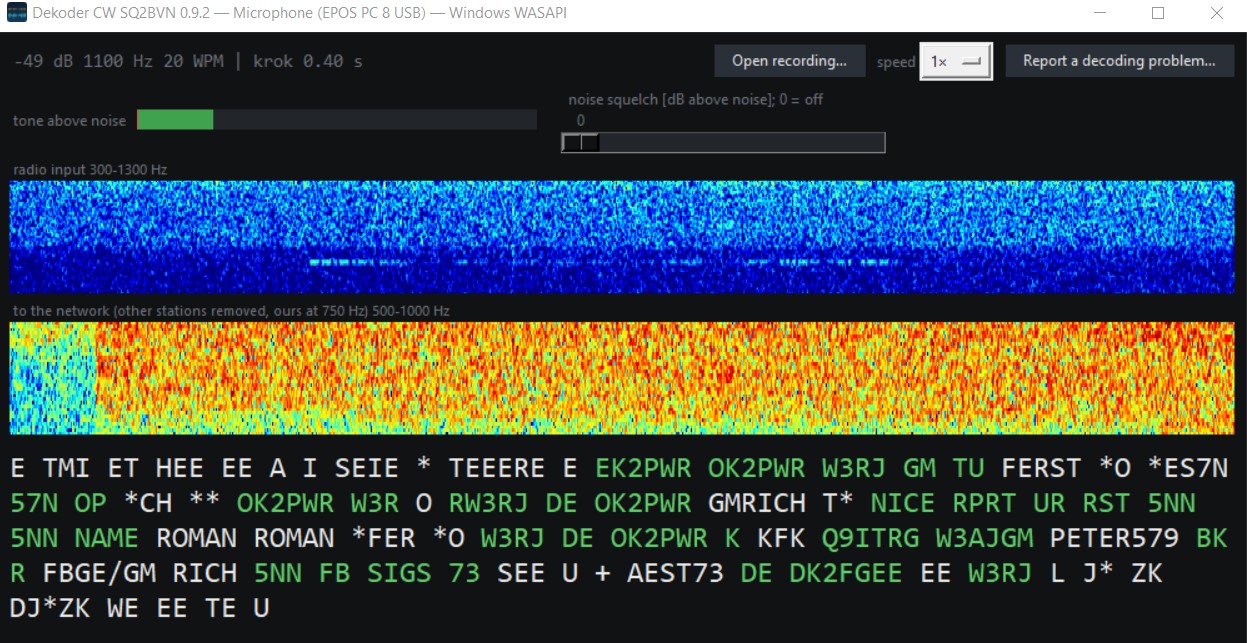
Polski amator radiowy SQ2BVN rozwija oprogramowanie typu open source Dekoder CW, ktorý kombinuje klasické DSP przetwarzanie sygnału audio za pomocą splotowej sieci neuronowej opartej na TensorFlow. Celem projektu nie jest wymiana ucha operatora w czystych warunkach – do tego wystarczy Goertzels detektor s adaptívnym prahom. Neurónová sieť má pridanú hodnotu tam, kde zlyhávajú klasické metódy: pri silnom QSB, QRM od susednej stanice, atmosférickom QRN a nepresnom ručnom kľúčovaní.
Przeczytasz w artykule
Ujednolicony front-end jako podstawa
Cały system opiera się na zasadzie jednego źródła prawdy o parametrach DSP. Konfiguracja w pliku config.py definiuje wszystkie stałe – zakres pasm mel (400-1200 Hz), liczbę filtrów mel (32), długość okna (2,56 s przy 128 klatkach przy 20 ms) oraz skalę decybeli ze stałymi limitami DB_MIN i DB_MAX. Wszystkie narzędzia – generator danych szkoleniowych, trener, wizualizacja i ścieżka na żywo – wywołują tę samą funkcję frontend.to_net_image() i dają identyczne wyniki. Eliminuje to typowy problem projektów ML, gdzie ścieżki szkoleniowe i produkcyjne korzystają z różnych normalizacji.
Ważny szczegół: projekt celowo nie stosuje normalizacji do maksimum klipu (REF=np.max), co spowodowałoby, że wynik byłby uzależniony od reszty nagrania. Skala decybelowa jest bezwzględna, co zapewnia powtarzalność – ten sam ton na tym samym poziomie da ten sam piksel niezależnie od otoczenia.
Model kanału radiowego
Generator danych szkoleniowych symuluje rzeczywiste warunki propagacji w pasmach KV, włączając sześć efektów: QSB (wahanie amplitudy), QRM (stacja zagłuszania pasma przepustowego), QRN (wyładowania atmosferyczne), nieprecyzyjne ręczne kluczowanie z odchyleniem ± 0-25%, dryft częstotliwości ± 8 Hz na klip i szum zmienny o barwie widmowej. Efekty można włączać indywidualnie, dzięki czemu można zmierzyć, który z nich model radzi sobie najgorzej. Zbiór szkoleniowy pustych klipów (klasa 0) zawiera także QRM – w ten sposób sieć dowiaduje się, że energia poza tonem nie jest cechą.
Rentgen – wizualna kontrola danych
Narzędzia xray.py i xray_all.py renderują próbki szkoleniowe jako kafelki PNG o wymiarach 128 × 32 pikseli ze wspólną skalą dB. Poniżej każdego kafelka znajduje się biały pasek wskazujący granice zaznaczonego znaku oraz kolorowe wskaźniki aktywnych efektów (QSB, QRM, QRN, kluczowanie). Sortowanie domyślne – kontrast sortowania rozpoczyna się od najcięższych próbek. Wizualizacja wykryje problemy z synchronizacją, zwisaniem postaci lub zbyt dużym szumem tła, zanim wpłyną one na dokładność modelu.
Architektura sieciowa i wdrażanie wbudowane
Domyślna architektura (–arch dpu) wykorzystuje wyłącznie warstwy splotowe z około 624 000 parametrów i rozmiarem modelu około 1,5 MB. Dla porównania istnieje architektura referencyjna z dwukierunkowym GRU, ale w testach osiągnęła tę samą dokładność na poziomie 97,51% – rekurencja nie uległa poprawie i była czterokrotnie wolniejsza. Pole recepcyjne sieci splotowej obejmuje 110 klatek (2,20 s), co wystarcza na najdłuższy znak łącznie ze spacjami.
Architekturę splotową wybrano pod kątem wdrożenia na platformie AMD Kria KV260 FPGA z akceleratorem DPUCZDX8G i narzędziami Vitis AI. DPU nie obsługuje warstw rekurencyjnych, dlatego nie można wdrożyć wariantu GRU. Dla frontonu mel na osadzonym celu istnieje czysto numpy referencyjna implementacja (melref.py), gotowa do przeniesienia do C. Kwantyzacja do int8 dla Vitis AI korzysta ze stałej skali dB - zakres kalibracji nie zależy od zawartości klipu.
Obecny model wyszkolony na 1,6 miliona próbek (RTX 3050, 120 minut) osiąga dokładność walidacji na poziomie 98,95% i dekoduje przy 10-30 WPM. Ograniczeniem pozostaje wąski zakres częstotliwości 670-830 Hz – niezbędne jest dostrojenie do odpowiedniego tonu, a zapewnia je moduł tune.py. Wersja 0.9.2 jest dostępna jako Instalator Windows, który nie wymaga uprawnień administratora i współpracuje z USB zvukovou kartou transceivera alebo mikrofónom.