
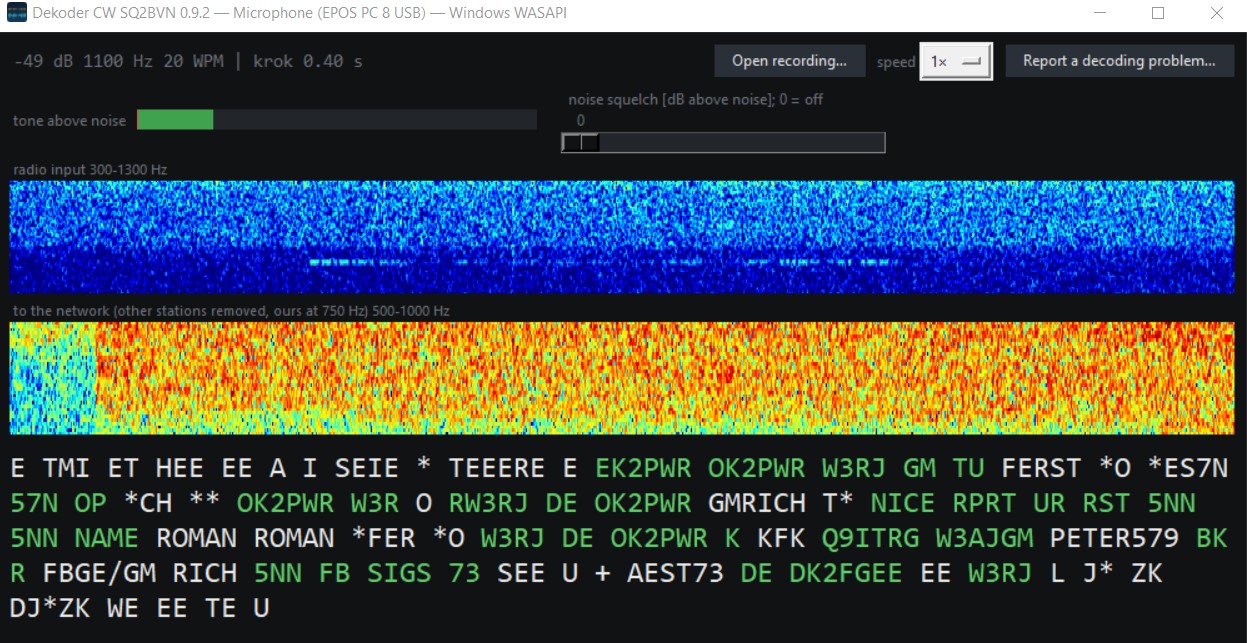
Polský radioamatér SQ2BVN vyvíjí open-source dekodér CW, ktorý kombinuje klasické DSP zpracování audio signálu s konvoluční neuronovou sítí na bázi TensorFlow. Cílem projektu není nahradit operátorovo ucho v čistých podmínkách – k tomu postačí Goertzelov detektor s adaptívnym prahom. Neurónová sieť má pridanú hodnotu tam, kde zlyhávajú klasické metódy: pri silnom QSB, QRM od susednej stanice, atmosférickom QRN a nepresnom ručnom kľúčovaní.
V článku se dočtete
Jednotný front-end jako základ
Celý systém stojí na principu jediného zdroje pravdy pro DSP parametry. Konfigurace v souboru config.py definuje všechny konstanty – rozsah mel pásem (400 – 1200 Hz), počet mel filtrů (32), délku okna (2,56 s při 128 snímcích po 20 ms) a decibelovou škálu s pevnými hranicemi DB_MIN a DB_MAX. Všechny nástroje – generátor trénovacích dat, trenér, vizualizace i živá cesta – volají stejnou funkci frontend.to_net_image() a produkují identický výstup. Tím se eliminuje typický problém ML projektů, kde trénovací a produkční cesta používají různé normalizace.
Důležitý detail: projekt záměrně nepoužívá normalizaci na maximum klipu (REF=np.max), která by způsobila závislost výstupu na zbytku nahrávky. Decibelová škála je absolutní, což zajišťuje reprodukovatelnost – stejný tón při stejné úrovni dá stejný pixel bez ohledu na okolí.
Model rádiového kanálu
Generátor trénovacích dat simuluje reálné podmínky šíření na KV pásmech včetně šesti efektů: QSB (kolísání amplitudy), QRM (rušící stanice v propustném pásmu), QRN (atmosférické výboje), nepřesné ruční klíčování s odchylkou ±0 – 25 %, frekven šum s plovoucí úrovní. Efekty lze zapínat jednotlivě, což umožňuje měřit, který z nich model zvládá nejhůře. Tréninková sada prázdných klipů (třída 0) obsahuje také QRM – síť se tak učí, že energie mimo tón není znak.
X-Ray – vizuální kontrola dat
Nástroje xray.py a xray_all.py vykreslují trénovací vzorky jako PNG dlaždice 128 × 32 pixelů se sdílenou dB škálou. Pod každou dlaždicí je bílý pás označující hranice označeného znaku a barevné indikátory aktivních efektů (QSB, QRM, QRN, klíčování). Výchozí řazení – sort contrast začíná od nejtěžších vzorků. Vizualizace odhalí problémy s časováním, přesahem znaku přes okraj okna nebo příliš vysokým šumovým pozadím dříve, než se projeví na přesnosti modelu.
Architektura sítě a embedded nasazení
Výchozí architektura (–arch dpu) používá výhradně konvoluční vrstvy s přibližně 624 000 parametry a velikostí modelu kolem 1,5 MB. Referenční architektura s obousměrným GRU existuje pro srovnání, ale při testování dosáhla stejné přesnosti 97,51 % – rekurence nepřinesla zlepšení a byla čtyřnásobně pomalejší. Receptivní pole konvoluční sítě pokrývá 110 snímků (2,20 s), což postačuje na nejdelší znak včetně mezer.
Konvoluční architektura je zvolena s ohledem na nasazení na FPGA platformě AMD Kria KV260 s akcelerátorem DPUCZDX8G a nástroji Vitis AI. DPU nepodporuje rekurentní vrstvy, proto GRU varianta není nasaditelná. Pro mel front-end na embedded cíli existuje čistě numpy referenční implementace (melref.py) připravená na port do C. Kvantizace na int8 pro Vitis AI profituje z pevné dB škály – kalibrační rozsah nezávisí na obsahu klipu.
Aktuální model trénovaný na 1,6 milionu vzorků (RTX 3050, 120 minut) dosahuje validační přesnosti 98,95 % a dekóduje rychlostí 10 – 30 WPM. Omezením zůstává úzký frekvenční rozsah 670 – 830 Hz – ladění na správný tón je nezbytné a zajišťuje jej modul tune.py. Verze 0.9.2 je dostupná jako Windows instalátor, který nevyžaduje administrátorská práva a pracuje s USB zvukovou kartou transceivera alebo mikrofónom.