
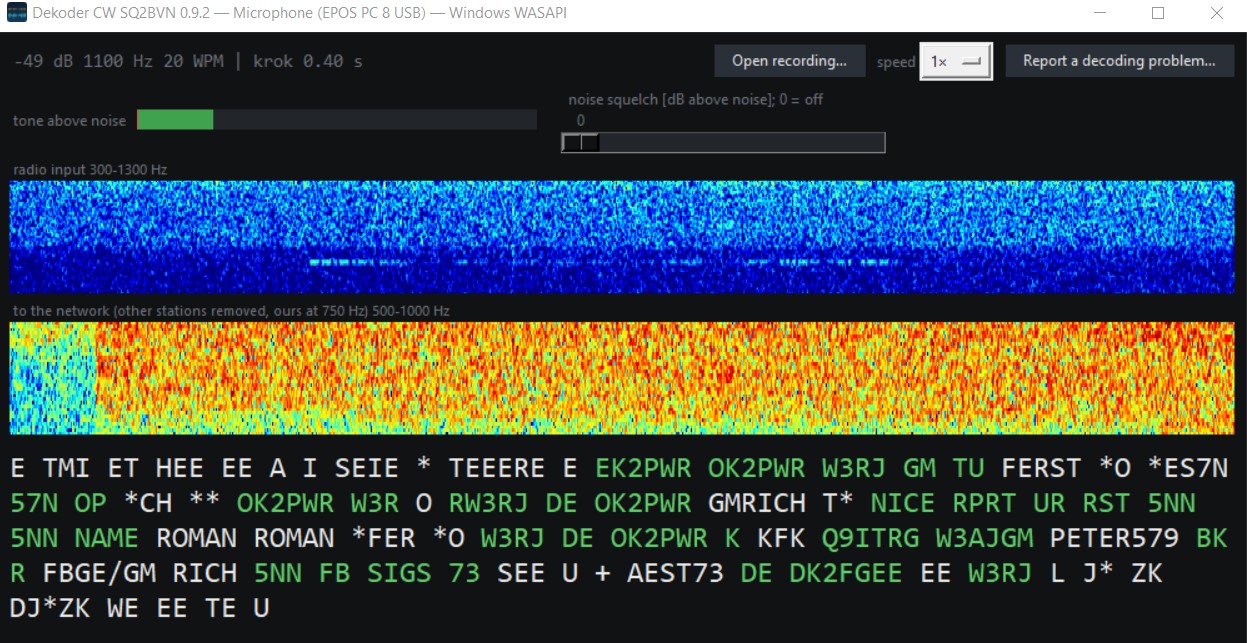
Der polnische Funkamateur SQ2BVN entwickelt Open Source CW-Decoder, ktorý kombinuje klasické DSP Audiosignalverarbeitung mit einem Faltungs-Neuronalen Netzwerk basierend auf TensorFlow. Ziel des Projekts ist es nicht, das Ohr des Bedieners unter sauberen Bedingungen zu ersetzen – dafür reicht Goertzels aus detektor s adaptívnym prahom. Neurónová sieť má pridanú hodnotu tam, kde zlyhávajú klasické metódy: pri silnom QSB, QRM od susednej stanice, atmosférickom QRN a nepresnom ručnom kľúčovaní.
Sie werden im Artikel lesen
Ein einheitliches Frontend als Grundlage
Das gesamte System basiert auf dem Prinzip einer einzigen Quelle der Wahrheit für DSP-Parameter. Die Konfiguration in der Datei config.py definiert alle Konstanten – den Bereich der Mel-Bänder (400–1200 Hz), die Anzahl der Mel-Filter (32), die Fensterlänge (2,56 s bei 128 Frames bei 20 ms) und die Dezibelskala mit festen DB_MIN- und DB_MAX-Grenzwerten. Alle Tools – Trainingsdatengenerator, Trainer, Visualisierung und Live-Pfad – rufen dieselbe frontend.to_net_image()-Funktion auf und erzeugen identische Ausgaben. Dadurch wird das typische Problem von ML-Projekten beseitigt, bei denen die Trainings- und Produktionspfade unterschiedliche Normalisierungen verwenden.
Wichtiges Detail: Das Projekt verzichtet bewusst auf eine Normalisierung auf das Maximum des Clips (REF=np.max), wodurch die Ausgabe vom Rest der Aufnahme abhängig wäre. Die Dezibelskala ist absolut, was die Reproduzierbarkeit gewährleistet – der gleiche Ton bei gleicher Lautstärke ergibt unabhängig von der Umgebung das gleiche Pixel.
Funkkanalmodell
Der Trainingsdatengenerator simuliert reale Ausbreitungsbedingungen auf KV-Bändern, einschließlich sechs Effekten: QSB (Amplitudenschwankung), QRM (Passband Jamming Station), QRN (atmosphärische Entladungen), ungenaue manuelle Umtastung mit ±0–25 % Abweichung, Frequenzdrift ±8 Hz pro Clip und spektral gefärbtes Floating-Level-Rauschen. Die Effekte können einzeln eingeschaltet werden, sodass gemessen werden kann, welche davon das Modell am schlechtesten bewältigt. Der Trainingssatz leerer Clips (Klasse 0) enthält auch QRM – auf diese Weise lernt das Netzwerk, dass Energie außerhalb des Tons kein Merkmal ist.
Röntgen – visuelle Kontrolle von Daten
Die Tools xray.py und xray_all.py rendern die Trainingsbeispiele als PNG-Kacheln mit 128 × 32 Pixeln und einer gemeinsamen dB-Skala. Unter jeder Kachel befindet sich ein weißes Band, das die Grenzen des markierten Zeichens anzeigt, sowie farbige Indikatoren für aktive Effekte (QSB, QRM, QRN, Keying). Die Standardsortierung – Sortierkontrast beginnt bei den schwersten Proben. Die Visualisierung erkennt Probleme mit dem Timing, Zeichenüberhängen oder zu viel Hintergrundrauschen, bevor sie die Genauigkeit des Modells beeinträchtigen.
Netzwerkarchitektur und eingebettete Bereitstellung
Die Standardarchitektur (–arch dpu) verwendet ausschließlich Faltungsschichten mit etwa 624.000 Parametern und einer Modellgröße von etwa 1,5 MB. Zum Vergleich gibt es eine Referenzarchitektur mit bidirektionalem GRU, die jedoch beim Testen die gleiche Genauigkeit von 97,51 % erreichte – die Rekursion verbesserte sich nicht und war viermal langsamer. Das Empfangsfeld des Faltungsnetzwerks umfasst 110 Frames (2,20 s), was für das längste Zeichen inklusive Leerzeichen ausreicht.
Die Faltungsarchitektur wird im Hinblick auf den Einsatz auf der AMD Kria KV260 FPGA-Plattform mit dem DPUCZDX8G-Beschleuniger und Vitis AI-Tools ausgewählt. DPU unterstützt keine wiederkehrenden Schichten, daher ist die GRU-Variante nicht einsetzbar. Für das Mel-Frontend auf dem eingebetteten Ziel gibt es eine reine Numpy-Referenzimplementierung (melref.py), die nach C portiert werden kann. Die Quantisierung auf int8 für Vitis AI profitiert von einer festen dB-Skala – der Kalibrierungsbereich hängt nicht vom Inhalt des Clips ab.
Das aktuelle Modell, das auf 1,6 Millionen Proben trainiert wurde (RTX 3050, 120 Minuten), erreicht eine Validierungsgenauigkeit von 98,95 % und dekodiert mit 10–30 WPM. Die Einschränkung bleibt der schmale Frequenzbereich von 670-830 Hz – die Abstimmung auf den richtigen Ton ist unerlässlich und wird vom tune.py-Modul bereitgestellt. Version 0.9.2 ist verfügbar als Windows Installer, das keine Administratorrechte erfordert und mit funktioniert USB zvukovou kartou transceivera alebo mikrofónom.