Einrichten der SSB-Audiokette mit EQ, Spektrumanalyse und Signalüberwachung
Nastavenie nízkofrekvenčnej cesty pri vysielaní jednopásmovou moduláciou (SSB) je často podceňovaným faktorom, ktorý zásadne ovplyvňuje zrozumiteľnosť a dosah signálu. Die meisten Funkamateure passen den Klang ihrer Intuition oder ihrem Zuhören über Kopfhörer an, was zu einer ineffizienten Nutzung der Hochfrequenzleistung führt. Kľúčom k profesionálne nastavenému SSB signálu je pochopenie psychoakustiky ľudského sluchu, predovšetkým der Norm ISO 226, die Kurven gleichen Volumens definiert (ursprünglich bekannt als Fletcher-Munson-Kurven).
Das menschliche Ohr nimmt nicht alle akustischen Frequenzen gleichermaßen wahr. Seine Empfindlichkeit ist nichtlinear und hängt vom Schalldruckpegel ab. Im Bereich von 1 kHz bis 4 kHz erreicht der menschliche Hörapparat seine höchste Empfindlichkeit, während er bei tiefen Frequenzen unter 300 Hz eine deutlich höhere akustische Energie benötigt, um die gleiche subjektive Lautstärke zu erreichen. Während der kommerzielle Rundfunk über eine Audiobandbreite von bis zu 20 kHz verfügt, ist der klassische Kurzwellen-SSB-Betrieb streng auf eine Kanalbreite von 2,4 kHz bis 3,0 kHz beschränkt. In diesem schmalen Band führt eine Fehlverteilung der akustischen Energie zu einem Verlust der Verständlichkeit und einer verschwendeten Spitzenleistungshüllkurve (PEP) der Sendeleistungsstufe.
Sie werden im Artikel lesen
Frequenzprofile: Easy Listening versus maximale Effizienz
Beim Einstellen der Entzerrung des SSB-Senders muss ein Betriebsziel ausgewählt werden. Aus Sicht des akustischen Spektrums unterscheiden wir zwei Grundprofile: ein Profil für angenehmes Hören (Easy Listening) und ein Profil für maximale Modulationseffizienz, das für den Contest- und DX-Betrieb gedacht ist.
Neues Tischmikrofon Icom SM-J1
Easy Listening-Profil
Das Easy Listening-Profil ist für regelmäßige lokale Sitzungen und Ragchewing mit starken S9+20-dB-Signalen konzipiert. Sein charakteristisches Merkmal ist ein natürlicher, angenehmer Klang ohne akustische Ermüdung des Zuhörers. Bei der Spektralanalyse besteht ein Unterschied von etwa 20 dB zwischen der Bassspitze (der ersten Oktave der Stimme, typischerweise 150 Hz bis 220 Hz) und der Unterdrückung im Bereich von 900 Hz bis 1 kHz. Dieser Abstand bewahrt die natürliche Farbe der Stimme, aber die Basskomponenten verbrauchen einen erheblichen Teil der gesamten PEP-Leistung.
Profil für maximale Effizienz
Im Gegenteil ist ein Profil für maximale Effizienz unerlässlich, wenn unter Bedingungen begrenzter Leistung (QRP, SOTA), mit Einschränkungen der Richtantenne oder bei anspruchsvollen Wettbewerbsinterferenzen gearbeitet wird. Ziel ist es, diesen spektralen Unterschied auf 0 dB zu komprimieren und eine flache Spektralcharakteristik zu erzeugen, die dem weißen Rauschen nahe kommt. Ein Hochfrequenzverstärker hat eine feste Spitzenleistungsgrenze. Wenn starke Bassfrequenzen in den Modulationspfad gelangen, führt dies dazu, dass die Ausgangsstufe vorzeitig ihren Höhepunkt erreicht. Durch das Absenken des dominanten Basses wird die verfügbare PEP-Leistung gleichmäßig über den gesamten Durchlassbereich von 300 Hz bis 2700 Hz verteilt. Auf der Empfängerseite können sowohl der digitale Signalprozessor (DSP) als auch das Ohr des Bedieners ein sehr schwaches Signal selbst unterhalb des Rauschpegels dekodieren.
Technische Mittel zur Formung des Audiosignals
SunSDR2-Radiosender und MFJ-Antennentuner
Die Gestaltung des Frequenzgangs erfordert geeignete Werkzeuge in der Audiokette. Im modernen SZR TCVR, wie SunSDR2 Pro, Yaesu FTDX-Serie, Kenwood TS-890 oder Icom IC-7300, parametrische Mehrband-Equalizer (Parametric EQ) und digitale Sprachprozessoren sind direkt verfügbar firmware zariadenia.
Für ältere TCVRs oder wenn erweiterte Modifikationen erforderlich sind, sind externe Funkamateur-Audioprozessoren (W2IHY 8-Band, UR6QW, I1WSM) oder Studio-19-Zoll-Rack-Schaltkreise mit Neve 1073-Mikrofonvorverstärkern, EQs und Multiband-Kompressoren. Bei der Verkabelung ist die richtige Impedanz- und Pegelanpassung von entscheidender Bedeutung. Der Mikrofoneingang an der Vorderseite des Senders arbeitet mit niedrigen Millivolt-Pegeln und erfordert bei Verwendung externer Netzteile eine galvanische Trennung, um Erdschleifen und RFI-Induktion (RFI) zu vermeiden. Die zweite Möglichkeit besteht darin, den hinteren Line-Eingang (ACC/DATA) oder die direkte digitale Audioübertragung über zu nutzen USB rozhranie a virtuálny audio kábel (VAC).
Methodik der objektiven Messung mithilfe der Monitor- und Audacity-Funktion
Es ist ein methodischer Fehler, sich bei der Einstellung der Modulation auf das eigene Hören über Kopfhörer direkt vom Sender zu verlassen. Interne akustische Bindungen durch die Schädelknochen verzerren die Wahrnehmung der eigenen Stimme. Die subjektive Schätzung muss durch eine objektive Spektralanalyse ersetzt werden.
Für die richtige Praxis ist es erforderlich, das modulierte Signal mit der integrierten Monitorfunktion des Senders abzutasten, die vor der endgültigen Übertragung demoduliertes Audio liefert, wobei der Sender unter künstlicher Last arbeitet und keine Störungen in das Band überträgt. Alternativ ist es möglich, einen sekundären linearen Empfänger vom Typ SDRplay mit ausgeschalteter interner AGC und flachem Frequenzgang zu verwenden. Das abgetastete Audiosignal wird einem Computer zugeführt, wo die kostenlose Audacity-Software eine Spektralanalyse mithilfe der Fast Fourier Transform (FFT) durchführt. Die Funktion „Spektralanalyse“ (Plot Spectrum) wird im Audacity-Menü verwendet, wobei die FFT-Fenstergröße auf 2048 oder 4096 Punkte und der Hanning-Fensterfilter eingestellt ist. Dadurch erhalten Sie ein genaues Diagramm der spektralen Leistungsdichte im Bereich von 0 Hz bis 4000 Hz.
Standardisierter Testtext zur Spektralanalyse
Das wiederholte Aussprechen des Satzes „CQ-Wettbewerb“ oder das Zählen ins Mikrofon ist für die Spektrumanalyse völlig unzureichend. Diese kurzen Ausdrücke enthalten nicht das gesamte Vokal- und Konsonantenspektrum und vermitteln ein verzerrtes Bild der durchschnittlichen Stimmleistung.
Um reproduzierbare Ergebnisse zu erzielen, ist eine kontinuierliche, frequenzreiche Rede von mindestens 30 Sekunden Dauer erforderlich. In der Akustiktechnik wird zum Kalibrieren von Mikrofonen ein standardisierter akustischer Satz verwendet: „Bitte Orange, ich bestehe darauf, dass Sie den braunen Reißverschluss vom blauen Mikrofonarm entfernen.“ Unter slowakischen Verhältnissen ist das flüssige Lesen eines Fachtextes, der stimmhafte und stimmlose Laute kombiniert, ein vollwertiger Ersatz. Für jede Testaufnahme ist es notwendig, den gleichen Abstand des Mundes zum Mikrofonwandler (typischerweise 5 bis 10 cm), den gleichen Sprechwinkel und eine konstante akustische Intensität der Stimme einzuhalten.
Verfahren zum Einrichten einer zyklischen Schleife und ALC-Steuerung
Etwas schlechte Qualität des SSB-Signals
Die Einstellung des Modulationspfades erfolgt in einem zyklischen Algorithmus. Der erste Schritt besteht darin, über die Monitor-Funktion in Audacity eine 30-sekündige Sprachprobe aufzunehmen. Der zweite Schritt besteht darin, die FFT-Spektralkurve zu erstellen. Im dritten Schritt erfolgt der Vergleich der gemessenen Kurve mit dem Sollprofil (ISO 226 oder FLAT). Der vierte Schritt ist die Korrektur der Parameter am Equalizer. Dieser Zyklus wird wiederholt, bis das gemessene Spektrum der gewünschten Form entspricht.
Die endgültige Einstellung der Mikrofonverstärkung (Mic Gain) und des Sprachprozessors (Speech Processor / Kompressor) erfolgt erst nach der Formung der Frequenzkurve. Die wichtigste Regel ist der korrekte Betrieb der automatischen Verstärkungsregelungsschaltung (ALC). Der ALC-Indikator muss sich bei Sprachspitzen ausschließlich im markierten linearen Feld bewegen. Wenn die ALC-Schaltung wach ist, gibt es eine harte Begrenzung der Signalhüllkurve. Das Ergebnis des ALC-Weckvorgangs ist keine höhere Lautstärke, sondern Phasenverzerrung, Intermodulationsprodukte höherer Ordnung (IMD), eine Vergrößerung der belegten Bandbreite und Splatter, der Sender auf benachbarten Kanälen stark stört.
Praktische Regeln zur Anpassung der Frequenzkurve
Bei der Einstellung des Equalizers für die SSB-Modulation gelten besondere elektroakustische Regeln zur Einstellung einzelner Bänder.
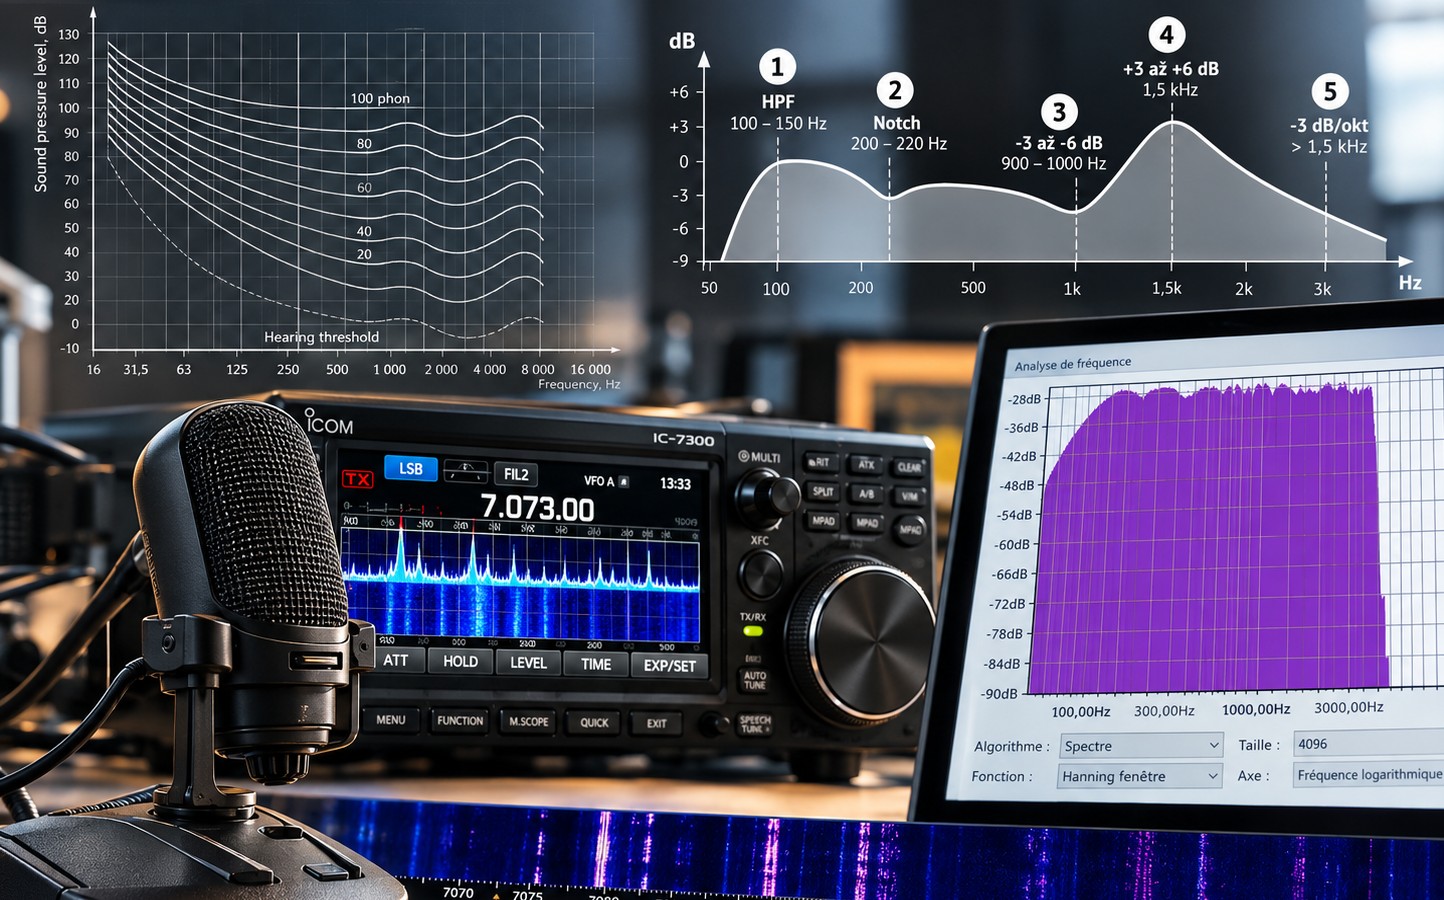
Fünf Schritte zum Anpassen der Frequenzkurve für ein besser verständliches SSB-Signal
Der erste Schritt besteht darin, Subbassfrequenzen unter 100 Hz bis 150 Hz mithilfe eines Hochpassfilters strikt abzuschneiden. Diese Frequenzen tragen nicht zur Sprachverständlichkeit bei, verursachen aber eine unnötige Überlastung der PA-Bühne und können 50-Hz-Netzbrummen oder akustische Schwingungen des Ventilators enthalten.
Der zweite Schritt besteht darin, die zweite harmonische Frequenz des Grundtons der Stimme mithilfe eines schmalen Notch-Filters (Notch-Filter) herauszuschneiden. Bei einer männlichen Stimme liegt diese zweite Harmonische typischerweise im Bereich von 200 Hz bis 220 Hz (z. B. 216 Hz). Durch die Unterdrückung wird der dröhnende und unklare Charakter des Klangs entfernt.
Der dritte Schritt ist die spektrale Unterdrückung im 900-Hz- bis 1000-Hz-Band. Durch die Unterdrückung dieses Bereichs wird der kastenförmige und nasal gefärbte Ton der Sprache beseitigt.
Im vierten Schritt wird ein leichter Auftrieb bei einer Frequenz von 1500 Hz (1,5 kHz) erzeugt. Dieser Bereich ist entscheidend für die Bildung von Formanten, die für die Verständlichkeit von Konsonanten verantwortlich sind.
Der fünfte Schritt besteht darin, eine absteigende Flanke von ca. -3 dB pro Oktave von 1500 Hz bis zum oberen Bandschnitt (2700 Hz bis 3000 Hz) einzustellen. Die unkontrollierte Betonung von Höhen über 2 kHz erweckt den Eindruck eines scharfen Signals, führt jedoch bei längerem Hören zu erheblicher Hörermüdung und erhöht bei falscher Phasenlage das Risiko des Peak-Wakeings.
Signalverifizierung im Echtbetrieb und Monitoring per WebSDR
Hochwertiges SSB-Signal
Das Anfordern von Modulationsberichten von Stationen im Band liefert keine objektiven Daten. Die empfangene Meldung unterliegt den Eigenschaften des Lautsprechers der Gegenstelle, der Akustik ihres Raumes und dem eingestellten Empfangs-DSP-Filter.
Die einzige unabhängige Möglichkeit der Verifizierung bei der realen Ausbreitung ist die Verwendung eines Netzwerks von KiwiSDR- und WebSDR-Empfängern, die sich in unterschiedlichen Entfernungen befinden.
Zeichnen Sie bei geringer Sendeleistung zu einer echten Antenne Ihr eigenes Signal auf einem entfernten SDR-Empfänger auf. Die Visualisierung im Spektrogramm (Wasserfall) zeigt sofort, ob das Signal spektral sauber ist, ob es den Durchlassbereich von 2,7 kHz nicht überschreitet und ob an den Spitzen keine unerwünschten Nebenprodukte entstehen. Durch den Import der aufgezeichneten Audiodatei aus WebSDR in das Audacity-Programm und die anschließende Spektralanalyse wird bestätigt, ob die Modulation die angegebene Kurve auch nach Durchlaufen des Ionosphärenkanals und der AGC-Schaltkreise des Empfängers beibehalten hat.
Vergleich der Betriebsprofile der SSB-Modulation
Parameter/Eigenschaft
Profil von Easy Listening (Ragchewing)
Profil Maximale Effizienz (Wettbewerb / DX / QRP)
Bassabstand / 1 kHz
Ungefähr 20 dB
Nahezu 0 dB (flache Kennlinie)
Bandbreite (SSB)
2,7 kHz bis 3,0 kHz
2,4 kHz bis 2,7 kHz
Subbassfilter (HPF)
Unter 80-100 Hz schneiden
Strenger Schnitt unter 150-200 Hz
900-1000-Hz-Band
Tal -6 dB bis -10 dB
Korrigiert auf den maximalen Basspegel
1,5-kHz-Bereich
Moderater Lift (+3 dB)
Aggressiver Boost (+6 dB), um im Lärm hervorzustechen
Nutzung der PEP-Leistung
Ein Teil der Kraft ist im Bass gebunden
100 % PEP im verständlichen Bereich verteilt
Betriebszweck
Lokale Sitzungen, S9+20 dB-Signale, komfortable Präsentation